قمة الجبل
قد يبدو الحديث عن SVD في عالم الجبر الخطي كالقفز مباشرةً إلى قمة جبل. لماذا نبدأ من أعلى النظرية قبل أن نعرف الطريق إليها؟
لا تقلق. لن نحفظ القمة ولن نضيع وسط متاهات البراهين. سنفعل شيئًا أبسط: سنقف فوقها قليلًا، ثم نبدأ في ها حتى نرى ممَّا تكوَّن الجبل.
من ال إلى التفكيك
وبما أننا نتحدث عن التفكيك — Decomposition، فلنبدأ من الاتجاه المعاكس: التجميع — Composition.
أمامنا ثلاث مصفوفات، و و. أبعادها متوافقة، ولذلك نستطيع أن نصلها ببعضها:
هذه هي الفكرة في أبسط صورة: نعرف القطع، نجمعها، فيظهر شيء جديد. وإذا دخل متجه إلى هذه السلسلة فإن العمل يبدأ من اليمين: ، أي
لنأخذ مثالًا صغيرًا:
وعند جمع هذه التحويلات نحصل على
الشكل 1: تركيب المصفوفات بوصفه تحويلات متتابعة. يعمل حاصل الضرب ABC على x من اليمين إلى اليسار: يحوّل C المدخل أولًا، ثم يتبعه B وA.
التجميع في Python
import numpy as np A = np.array([[1., 2.], [0., 1.]]) B = np.array([[2., 0.], [0., 0.5]]) C = np.array([[0., -1.], [1., 0.]]) W = A @ B @ Cprint(W)هذا هو الاتجاه السهل في القصة: القطع معروفة، ولذلك نبني منها ال النهائية.
هنا تلمس التجميع بدل أن تقرأ تعريفه فقط. غيّر ، واضغط على المصفوفات، وراقب كيف تمر ال من إلى ثم إلى .
والآن اقلب السؤال: بدل أن أعطيك القطع، أضع أمامك مصفوفة واحدة اسمها . نرى صفوفها وأعمدتها، ونستطيع أن نحسب رتبتها وكل ما يظهر لنا منها. ثم أقول لك: افتحها. أرني البنية التي تختبئ في داخلها.
لو لم تكن لدينا أدوات، لاستطعنا التخمين حتى تحترق النجوم. لكن هذا بالضبط هو السبب الذي جعل علماء الجبر الخطي يبنون نظريات الـdecomposition: لا نريد أي عوامل عشوائية؛ نريد قطعًا لها معنى وبنية نستطيع الاستفادة منها.
قد تكون القطع مثلثية كما في LU، أو اتجاهات orthonormal ومعاملات مثلثية كما في QR، أو عاملًا مثلثيًا وانعكاسه كما في Cholesky. وقد نغيّر زاوية النظر نفسها كما في Spectral decomposition وSchur، أو نفصل الدوران عن التمدد كما في Polar decomposition. ثم نصل إلى SVD، الذي سيأخذ المسرح من هنا.
أطلس التفكيك
الأسماء كثيرة، لكن الفكرة واحدة: لا تقاتل المصفوفة بالشكل الذي وصلت به إليك. ابحث عن تمثيل يجعل عمل كل قطعة واضحًا.
في العنصر التالي اختر LU أو QR أو Cholesky أو Spectral أو SVD. افتح العوامل، ثم أعد بناء المصفوفة الأصلية. لا تحفظ الصيغ؛ راقب النمط وهو يتكرر.
LU يحول Gaussian elimination إلى عاملين يمكن إعادة استخدامهما.
| 4 | 3 |
| 6 | 3 |
| 1 | 0 |
| 1.5 | 1 |
| 4 | 3 |
| 0 | -1.5 |
مثلثية سفلية: تحفظ معاملات elimination.
الشكل 2: طرق تفكيك المصفوفات. تمثل خمسة تفكيكات المصفوفة نفسها ببنى مختلفة، وتوفر عوامل كل تفكيك مسارًا لإعادة بناء A.
أطلس تفكيك صغير في Python
import numpy as np A = np.array([[4., 2.], [2., 3.]]) # QRQ, R = np.linalg.qr(A)print(np.allclose(A, Q @ R)) # SVDU, s, Vt = np.linalg.svd(A)Sigma = np.diag(s)print(np.allclose(A, U @ Sigma @ Vt)) # Spectral decomposition for symmetric Alam, E = np.linalg.eigh(A)print(np.allclose(A, E @ np.diag(lam) @ E.T)) # Cholesky for positive-definite AL = np.linalg.cholesky(A)print(np.allclose(A, L @ L.T))وباستخدام SciPy يمكن حساب بعض التفكيكات مباشرة:
import numpy as npfrom scipy.linalg import lu, schur, polar A = np.array([[4., 2.], [2., 3.]]) P, L, U_lu = lu(A)T, Z = schur(A)Qp, H = polar(A) print(np.allclose(A, P @ L @ U_lu))print(np.allclose(A, Z @ T @ Z.T))print(np.allclose(A, Qp @ H))ومن هنا لا يعود SVD قفزة غريبة. أصبح مجرد التفكيك الذي سنقترب منه أكثر من أي تفكيك آخر.
الجوهر فقط
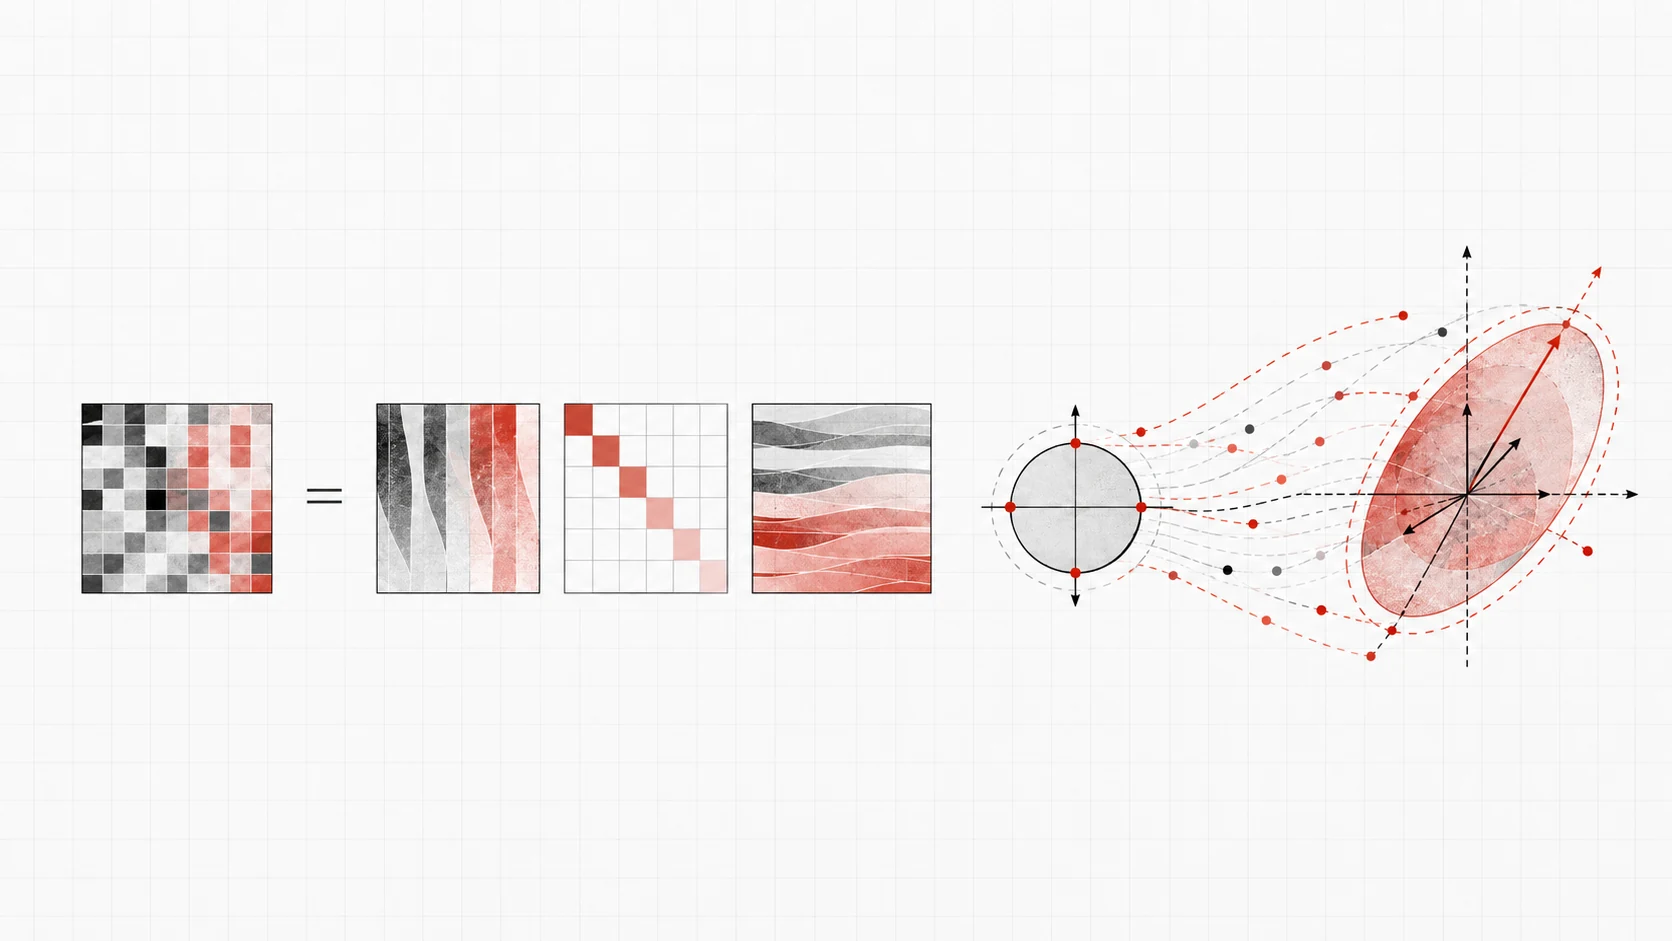
لأي مصفوفة حقيقية ، يمكننا كتابة
في الصورة الكاملة يكون مصفوفة ة من الحجم ، و مصفوفة متعامدة من الحجم ، بينما مستطيلة من الحجم .
على قطر توجد القيم المفردة:
أعمدة هي right singular vectors، وأعمدة هي left singular vectors. ولو كانت العناصر مركبة نستبدل بالـconjugate transpose .
متجه الإدخال
اختر متجهًا لتحويله.
الشكل 3: تحويل المتجه وفق SVD. يفصل التفكيك تحويل المتجه إلى تغيير متعامد للإحداثيات بواسطة Vᵀ، وتمدد بواسطة Σ، وإعادة توجيه بواسطة U.
هذه هي الصيغة. أمّا المعنى فيظهر عندما نرى وظيفة كل قطعة.
احسب SVD وتحقق منه
import numpy as np A = np.array([[3., 1.], [1., 2.]]) U, s, Vt = np.linalg.svd(A)Sigma = np.diag(s) print("U =\n", U)print("singular values =", s)print("V^T =\n", Vt) print("U^T U =\n", U.T @ U)print("V^T V =\n", Vt @ Vt.T) A_reconstructed = U @ Sigma @ Vtprint(A_reconstructed)print("error =", np.linalg.norm(A - A_reconstructed))ولمصفوفة مستطيلة استخدم
import numpy as np A = np.array([[3., 1.], [1., 2.]])U, s, Vt = np.linalg.svd(A, full_matrices=False)إذا كانت نسخة compact/economy هي كل ما تحتاجه.
من اليمين تبدأ الحكاية
إذا أدخلنا متجهة ، فلدينا .
ابدأ من . هذه القطعة لا “تشوّه” المتجهة كيفما اتفق؛ هي تسأل: كم تحتوي من كل اتجاه خاص ؟ فعلًا، إذا كتبنا ، فإن
إذن يحلل المدخل في إحداثيات صُممت خصيصًا لهذه المصفوفة.
ثم تصل الإحداثيات إلى . لا توجد هنا مزاوجة معقدة بين المحاور؛ كل اتجاه يُضرب في رقم واحد:
وهنا تكمن بساطة SVD: التحويل المعقد صار في هذه الإحداثيات مجرد stretch/shrink مستقل لكل محور.
وأخيرًا تأتي لتضع هذه المركبات بعد تمددها في اتجاهاتها المناسبة داخل فضاء الخرج.
لذلك يمكن أن نحفظ القصة لا الحروف:
يحلّل (V^T) المدخل، ثم تمدّد (Sigma) مركباته أو تقلّصها، وأخيرًا يوجّه (U) الخرج.
والجملة التي تختصر كل ذلك هي
أدخل الاتجاه الخاص ، فتخرج في اتجاه بعد أن يتغير طولها بمقدار .
سر الجمال
هنا يظهر أول سبب يجعل SVD جميلًا: الـeigendecomposition التقليدي يريد مصفوفة مربعة، لأن معادلة
تحتاج أن يعيش و في الفضاء نفسه.
لكن إذا كانت و، فليس هناك سبب لأن يكون فضاء المدخل هو فضاء الخرج.
SVD لا يحاول إجبار الفضاءين على أن يكونا واحدًا. يعطي المدخل ه الخاص ، ويعطي الخرج أساسه الخاص . هذا ليس حلًا التفافيًا للمشكلة؛ هذه هي الفكرة التي تجعل SVD طبيعيًا للمصفوفات المستطيلة.
حين تتحول الدائرة
تخيل دائرة الوحدة في بعدين. كل نقطة عليها تمثل متجهة طولها واحد. عندما نطبّق ، تتغير الإحداثيات دون أن تتغير الأطوال لأن orthogonal. ثم تأتي فتمد محورًا أكثر من الآخر، فتحول الدائرة إلى ellipse. بعدها تدور النتيجة أو تعكسها لتضعها في الاتجاه النهائي.
دائرة الوحدةيبدأ كل اتجاه بالطول الوحدي نفسه.
الشكل 4: الأثر الهندسي لتفكيك SVD. تعيد Vᵀ تمثيل دائرة الوحدة في أساس متعامد جديد، ثم تمددها Σ إلى قطع ناقص، ويحدد U اتجاهها النهائي؛ وتحدد القيم المفردة أطوال المحاور.
دع الهندسة تتحرك
import numpy as npimport matplotlib.pyplot as plt A = np.array([[3., 1.], [1., 2.]]) U, s, Vt = np.linalg.svd(A)Sigma = np.diag(s) theta = np.linspace(0, 2*np.pi, 500)circle = np.vstack([np.cos(theta), np.sin(theta)]) after_vt = Vt @ circleafter_sigma = Sigma @ after_vtafter_u = U @ after_sigma plt.figure(figsize=(6, 6))plt.plot(after_u[0], after_u[1])plt.axhline(0)plt.axvline(0)plt.gca().set_aspect("equal", adjustable="box")plt.title("Final image of the unit circle under A")plt.show()للتعليم من الأفضل متابعة circle ثم after_vt ثم after_sigma ثم after_u مرحلةً بعد مرحلة. وفي النسخة التفاعلية نتابع الجسم نفسه وهو يتغير بدل الاعتماد على صور منفصلة.
لهذا يقال كثيرًا إن SVD هو “دوران/انعكاس، ثم تمدد، ثم دوران/انعكاس”. العبارة مفيدة، لكن النسخة الأدق هي أن يختار نظام إحداثيات المدخل، و يقوم بالفعل المستقل على كل محور، و يختار نظام إحداثيات الخرج.
من أين تأتي هذه القطع؟
الآن وصلنا إلى سؤال مهم: هل اخترعنا هذه الاتجاهات لأنها تبدو جميلة؟ لا. ابدأ من المعادلة .
اضرب من اليسار بـ:
وفي SVD نحصل أيضًا على ، إذن .
ها هو السر: الـ هي للمصفوفة ، ومربعات هي لها.
وبالمثل ، فتكون eigenvectors لـ.
وهذا يفسر لماذا القيم المفردة غير سالبة: موجبة شبه محددة، وبالتالي eigenvalues الخاصة بها غير سالبة، ثم نأخذ الجذر .
أول خيط:
إذا أردت أن تبني SVD للتعلم لا للحساب العددي الاحترافي، ابدأ بـ. استخرج eigenvectors متعامدة معيارية ورتب eigenvalues تنازليًا. من كل eigenvalue اصنع
وحين تكون ، مرر داخل ، ثم اقسم على مقدار التمدد:
بهذه الطريقة لا نسحب و و من قبعة ساحر. تخبرنا بالاتجاهات المهمة في فضاء المدخل، eigenvalues تخبرنا بقوة التمدد، و نفسها تخبرنا أين تصل هذه الاتجاهات في فضاء الخرج.
هذا الطريق ممتاز للفهم. أما في العمل العددي الحقيقي فسنعتمد على خوارزميات SVD مستقرة مباشرة بدل تكوين دائمًا، لأن تربيع condition number قد يزيد المشكلات العددية.
ابنِ SVD من
هذا مفيد لفهم النظرية. أما في العمل العددي الحقيقي فالأفضل استخدام np.linalg.svd مباشرة.
import numpy as np def svd_from_ata(A, tol=1e-12): A = np.asarray(A, dtype=float) # 1. Symmetric positive-semidefinite Gram matrix G = A.T @ A # 2. Its orthonormal eigenvectors become right singular vectors eigenvalues, V = np.linalg.eigh(G) # 3. Sort from largest to smallest order = np.argsort(eigenvalues)[::-1] eigenvalues = np.maximum(eigenvalues[order], 0.0) V = V[:, order] # 4. Singular values are square roots s = np.sqrt(eigenvalues) # 5. Keep the nonzero part for the condensed SVD keep = s > tol s = s[keep] V = V[:, keep] # 6. Av_i = sigma_i u_i U = A @ V / s return U, s, V.Tبرهان الوجود
ما الذي نريد إثباته فعلًا؟
حتى الآن عرفنا كيف نفهم SVD وكيف نبنيه بطريقة تعليمية. لكن تبقى قفزة مهمة: لماذا نضمن أن كل مصفوفة تملك SVD أصلًا؟
لنفترض ، و.
نريد أن نثبت وجود صيغة condensed SVD:
بحيث أعمدة وأعمدة orthonormal، و
إذا كانت الرموز المركبة مزعجة، تذكر فقط أن في الحالة الحقيقية.
الأداة التي سنستعملها هي spectral theorem: كل مصفوفة تملك أساسًا orthonormal من eigenvectors، ويمكن كتابتها في صورة
المشكلة الة أن قد لا تكون مربعة ولا Hermitian. إذن بدل أن نحاول إجبار على شيء ليست عليه، سنبني مصفوفة أكبر تحمل داخلها.
الحيلة التي تفتح الباب
عرّف
حجمها ، فهي مربعة. والأهم أن ، إذن Hermitian، وبالتالي مفتوح لنا.
خذ eigenvector لـ واكتبه على قطعتين:
بتوسيع الضرب الكتلي نحصل على
أي و.
انظر إلى أول معادلة. إنها تقريبًا التعريف الذي كنا نبحث عنه: يتصرف كـright singular vector، و كـleft singular vector، و كـsingular value.
قد تكون A مستطيلة، لذلك eigendecomposition المباشر ليس متاحًا.
الشكل 5: برهان وجود تفكيك القيم المفردة. تُضمّن المصفوفة المستطيلة في مصفوفة هيرميتية أكبر، ثم تُستخدم المبرهنة الطيفية لاستخراج أزواج المتجهات المفردة المتعامدة التي تكوّن تفكيك SVD.
افحص برهان الـblock matrix عدديًا
import numpy as np A = np.array([[3., 1.], [0., 2.], [2., 2.]]) U, s, Vt = np.linalg.svd(A, full_matrices=False) m, n = A.shapeW = np.block([ [np.zeros((m, m)), A], [A.T, np.zeros((n, n))]]) # Hermitian/symmetric, so eigvalsh is appropriatew_eigenvalues = np.linalg.eigvalsh(W) expected = np.sort( np.concatenate([ -s, np.zeros(m + n - 2*len(s)), s ])) print(w_eigenvalues)print(expected)print(np.allclose(w_eigenvalues, expected))هذه التجربة العددية تعرض ما يتنبأ به البرهان تمامًا:
هذه هي الحيلة المركزية للبرهان كله: نحول مشكلة SVD لمصفوفة ربما تكون مستطيلة إلى eigenvalue problem لمصفوفة Hermitian أكبر.
لماذا تأتي القيم أزواجًا؟
إذا كان
eigenvector بقيمة ، فانظر إلى
باستخدام و نجد
إذن القيم غير الصفرية تأتي في أزواج .
وبما أن Hermitian، فإن eigenvectors المرتبطة بقيم eigenvalues مختلفة يمكن اختيارها متعامدة. هذه المعلومة هي التي ستعطينا لاحقًا للاتجاهات المفردة.
نجمع القطع
نختار
بحيث يكون .
قد يبدو الرقم 2 غريبًا، لكنه مقصود: نريد في النهاية أن يكون لكل من و طول يساوي 1.
لدينا .
ومن تعامد eigenvector المرتبط بـ مع النظير المرتبط بـ نحصل على
نجمع المعادلتين فنحصل على ، ونطرحهما فنحصل على .
الآن نجمع المتجهات في مصفوفتين:
ونضع القيم المفردة في .
وباستخدام spectral decomposition للمصفوفة ، ثم ضرب الكتل ومقارنة الجزء العلوي الأيمن، نحصل على ما أردناه:
لماذا تبقى الاتجاهات نظيفة؟
وحدة الطول حصلنا عليها بالفعل. بقي أن نثبت أن الأعمدة المختلفة متعامدة.
لـ، تعامد eigenvectors لـ يعطينا
وعندما نقارن eigenvector الموجب للأول مع النظير ذي الإشارة السالبة للثاني نحصل على
اجمع المعادلتين: . واطرحهما: . وهكذا و.
لم نعد نملك حدسًا فقط. لقد أثبتنا وجود الـcondensed SVD.
البرهان في نفس واحد
إذا ضاعت التفاصيل، لا تحفظ الصفحات. احفظ الحركة.
نبدأ بـ، ثم نخفيها داخل
Hermitian، لذلك تعطينا spectral theorem eigenvectors متعامدة معيارية. نقسم كل eigenvector إلى جزأين و، فتخرج لنا المعادلتان
نجمع في ، و في ، والقيم في ، فنستعيد
الـsingular vectors لم تظهر من العدم. كانت مختبئة داخل eigenvectors لمصفوفة Hermitian صممناها بعناية.
من حاصل ضرب إلى طبقات
حتى الآن رأينا SVD كآلة من ثلاث مراحل. الآن سنديرها قليلًا لنرى صورة ثانية لا تقل أهمية. اكتب و.
لأن قطرية، يمكن فتح حاصل الضرب إلى مجموع:
كل مصفوفة ، لأن كل أعمدتها مضاعفات عددية من .
إذن SVD يقول شيئًا مدهشًا وبسيطًا في الوقت نفسه:
المصفوفة طبقات rank-1 مرتبة من الأقوى إلى الأضعف.
الشكل 6: كتابة المصفوفة كمجموع حدود من الرتبة الأولى. تُكتب A مجموعًا لحدود من الشكل σᵢuᵢvᵢᵀ. وتؤدي إضافة الحدود تباعًا إلى تحسين إعادة البناء وتقليل الباقي.
انظر إلى المصفوفة
حتى heatmap بسيطة للمصفوفة قد تكفي لكي تصبح البنية مرئية:
import numpy as npimport matplotlib.pyplot as plt A = np.array([ [5., 4., 3., 2., 1.], [4., 3.2, 2.4, 1.6, 0.8], [3., 2.4, 1.8, 1.2, 0.6], [2., 1.6, 1.2, 0.8, 0.4], [1., 0.8, 0.6, 0.4, 0.2],]) plt.figure(figsize=(7, 5))im = plt.imshow(A, aspect="auto")plt.colorbar(im)plt.title("Matrix values")plt.xlabel("column")plt.ylabel("row")plt.show()استعمل العرض نفسه كسرد متصل: ابدأ بالمصفوفة الأصلية ، ثم اعزل طبقة rank-1، ثم اعرض truncated reconstruction ، وفي النهاية انظر إلى residual . هكذا يصبح matrix decomposition شيئًا نراه يتحرك بدل أن يكون مجرد رموز.
اسحب طبقات rank-1 واحدةً واحدة
import numpy as np A = np.array([ [5., 4., 3., 2., 1.], [4., 3.2, 2.4, 1.6, 0.8], [3., 2.4, 1.8, 1.2, 0.6], [2., 1.6, 1.2, 0.8, 0.4], [1., 0.8, 0.6, 0.4, 0.2],])U, s, Vt = np.linalg.svd(A, full_matrices=False)layers = [s[i] * np.outer(U[:, i], Vt[i, :]) for i in range(len(s))] # Exact reconstructionA_again = sum(layers)print(np.allclose(A, A_again))كل layer_i رتبتها لا تتجاوز 1.
ولعرض إحدى الطبقات:
import matplotlib.pyplot as pltimport numpy as np A = np.array([ [5., 4., 3., 2., 1.], [4., 3.2, 2.4, 1.6, 0.8], [3., 2.4, 1.8, 1.2, 0.6], [2., 1.6, 1.2, 0.8, 0.4], [1., 0.8, 0.6, 0.4, 0.2],])U, s, Vt = np.linalg.svd(A, full_matrices=False)first_layer = s[0] * np.outer(U[:, 0], Vt[0, :]) plt.figure()plt.imshow(first_layer, aspect="auto")plt.colorbar()plt.title("First rank-1 SVD layer")plt.show()القيمة هي قوة الطبقة. إذا كانت صفرًا، فالطبقة لا تضيف شيئًا. ومن هنا نحصل على حقيقة مهمة:
كم قطعة نحتاج؟
يمكن أيضًا فهم rank من زاوية البناء. إذا كانت
فيمكن بناء من قطع rank-1، ولا يمكن فعل ذلك باستخدام قطع rank-1 فقط.
هذه ليست مجرد صورة جميلة؛ إنها تعيد تفسير معنى الرتبة نفسه: كم اتجاهًا مستقلًا نحتاج حتى نبني المصفوفة؟
وهذا يقود طبيعيًا إلى rank factorization. إذا
وكان لـ عدد من الأعمدة، فإن كل أعمدة تعيش داخل span لتلك الأعمدة، ولذلك
إذا كانت rank الفعلية تساوي ، فلن تستطيع ضغط البعد الداخلي تحت مع الحفاظ على المساواة التامة.
SVD يعطينا rank factorization خاصة جدًا، لكنها لا تكتفي بأي أساس؛ تختار اتجاهات orthonormal وترتبها حسب القوة.
حين نقبل أن نفقد قليلًا
لنفترض أن
إذا كانت أول عدة قيم مفردة كبيرة والبقية صغيرة، قد نقرر الاحتفاظ بأول طبقات فقط:
نحن هنا لا نزعم أن . نحن نختار أن نخسر جزءًا من المعلومة مقابل تمثيل أبسط.
| 5 | 4 | 1 | 0 |
| 4 | 5 | 1 | 0 |
| 1 | 1 | 3 | 2 |
| 0 | 0 | 2 | 3 |
| 4.38 | 4.38 | 1.53 | 0.48 |
| 4.38 | 4.38 | 1.53 | 0.48 |
| 1.53 | 1.53 | 0.54 | 0.17 |
| 0.48 | 0.48 | 0.17 | 0.05 |
| 0.62 | -0.38 | -0.53 | -0.48 |
| -0.38 | 0.62 | -0.53 | -0.48 |
| -0.53 | -0.53 | 2.46 | 1.83 |
| -0.48 | -0.48 | 1.83 | 2.95 |
الشكل 7: إعادة البناء منخفضة الرتبة. تُعرض المصفوفة A وتقريبها من الرتبة k والباقي A − Aₖ بمقياس لوني موحّد. يحسّن رفع k التقريب ويقلل خطأ فروبينيوس.
truncated SVD
import numpy as np U, s, Vt = np.linalg.svd(A, full_matrices=False) k = 3A_k = (U[:, :k] * s[:k]) @ Vt[:k, :] error = np.linalg.norm(A - A_k, ord="fro")tail_error = np.sqrt(np.sum(s[k:]**2)) print("Frobenius error:", error)print("tail singular-value formula:", tail_error)القيمتان تتفقان حتى حدود الدقة العددية.
ما الذي خسرناه؟ الفرق هو .
ولقياس حجمه نستعمل Frobenius norm:
وبسبب تعامد طبقات SVD نحصل على
أي أن خطأ الحذف ليس لغزًا؛ إنه مجموع طاقات الطبقات التي قررنا تركها خلفنا.
لماذا القطع الأولى هي الأفضل؟
هنا تأتي واحدة من أجمل نتائج القصة. truncated SVD ليس مجرد طريقة معقولة لاختيار rank- approximation. إنه الأفضل في Frobenius norm.
إذا كان أي مصفوفة تحقق ، فإن
أي أنه إذا أعطيتك ميزانية لا تسمح إلا بـ اتجاهات مستقلة، فلن تجد rank- matrix أقرب إلى من truncated SVD.
الفكرة وراء البرهان هي أن row space لأي رتبتها لا تتجاوز لا يمكن أن تلتقط أكثر من اتجاهات مستقلة. إذا أسقطنا على أي فضاء بعده ، فإن أكبر طاقة يمكن الاحتفاظ بها تأتي من الاتجاهات المرتبطة بأكبر singular values. لذلك اختيار ليس ذوقًا؛ هو الاختيار الذي يحتفظ بأكبر مقدار ممكن من .
وبالتالي يكون الجزء المفقود أصغر ما يمكن:
هذه هي روح Eckart–Young: إذا كان عليك أن تنسى، فانْسَ أضعف الاتجاهات أولًا.
أين نتوقف؟
النظر إلى singular-value spectrum يشبه النظر إلى طبقات الجبل من جانبه. إذا هبطت القيم بسرعة ثم ظهر ذيل طويل صغير، فهذا يخبرنا أن كثيرًا من البنية يمكن وصفه بعدد قليل من الاتجاهات.
الشكل 8: طيف القيم المفردة واختيار الرتبة. تُظهر القيم المفردة المرتبة مكونات مهيمنة يعقبها انخفاض حاد. وتتغير الطاقة المحتفظ بها وخطأ إعادة البناء وفق الرتبة k المختارة.
singular values وخطأ التقريب
import numpy as np A = np.array([[3., 1.], [0., 2.], [2., 2.]])U, s, Vt = np.linalg.svd(A, full_matrices=False) k = 3A_k = (U[:, :k] * s[:k]) @ Vt[:k, :] error = np.linalg.norm(A - A_k, ord="fro")tail_error = np.sqrt(np.sum(s[k:]**2)) print("Frobenius error:", error)print("tail singular-value formula:", tail_error)خطأ Frobenius الأمثل عند rank-:
import numpy as npimport matplotlib.pyplot as plt A = np.array([[3., 1.], [0., 2.], [2., 2.]])s = np.linalg.svd(A, compute_uv=False) errors = []for k in range(len(s) + 1): errors.append(np.sqrt(np.sum(s[k:]**2))) plt.figure()plt.plot(range(len(s)+1), errors, marker="o")plt.xlabel("k")plt.ylabel("||A - A_k||_F")plt.title("Best rank-k approximation error")plt.show()مقياس شائع هو الطاقة المحتفظ بها:
لا يوجد سحري يصلح لكل مشكلة. اختيار هو مقايضة بين البساطة والدقة، وفي التطبيقات الحقيقية قد تدخل أيضًا قيود الذاكرة والزمن وأداء المهمة نفسها.
وهنا تدخل PCA
لنفترض أن data matrix مركز حول المتوسط، وفيه observations على الصفوف و features على الأعمدة.
نفككه:
مصفوفة هي
باستخدام SVD:
إذن
وهنا نرى الجسر بوضوح: أعمدة هي principal directions، وeigenvalues للـcovariance تساوي
إذن SVD لا يصبح PCA تلقائيًا لمجرد أننا نفكك أي مصفوفة. نحتاج أولًا إلى تفسير data matrix، وعادةً إلى mean centering، ثم نستخدم SVD كآلة حسابية ونظرية لاستخراج اتجاهات أكبر variance.
الشكل 9: إسقاط PCA على المركبة الرئيسية الأولى. تُسقط المشاهدات عموديًا على PC₁، التي تفسر 99.2% من التباين في هذا المثال؛ وتمثل الإزاحة العمودية الباقي.
PCA مباشرة من SVD
import numpy as np X = np.array([ [2.5, 2.4], [0.5, 0.7], [2.2, 2.9], [1.9, 2.2], [3.1, 3.0], [2.3, 2.7], [2.0, 1.6], [1.0, 1.1], [1.5, 1.6], [1.1, 0.9],]) # X: rows = observations, columns = featuresX = np.asarray(X, dtype=float) # 1. Center each featuremean = X.mean(axis=0, keepdims=True)Xc = X - mean # 2. SVD of centered dataU, s, Vt = np.linalg.svd(Xc, full_matrices=False) # Principal directionscomponents = Vt # Principal-component scoresscores = Xc @ components.T# equivalently: scores == U * s # Covariance eigenvalues / explained variancesn = X.shape[0]explained_variance = s**2 / (n - 1)explained_ratio = explained_variance / explained_variance.sum() print("components:\n", components)print("explained variance:", explained_variance)print("explained ratio:", explained_ratio)ولخفض البيانات إلى components:
import numpy as np X = np.array([ [2.5, 2.4], [0.5, 0.7], [2.2, 2.9], [1.9, 2.2], [3.1, 3.0], [2.3, 2.7], [2.0, 1.6], [1.0, 1.1], [1.5, 1.6], [1.1, 0.9],])mean = X.mean(axis=0, keepdims=True)Xc = X - meanU, s, Vt = np.linalg.svd(Xc, full_matrices=False)components = Vtscores = Xc @ components.T k = 1Z = scores[:, :k] # compressed coordinatesXc_reconstructed = Z @ components[:k, :]X_reconstructed = Xc_reconstructed + meanدع PCA يتحرك
للبيانات ثنائية الأبعاد:
import matplotlib.pyplot as pltimport numpy as np X = np.array([ [2.5, 2.4], [0.5, 0.7], [2.2, 2.9], [1.9, 2.2], [3.1, 3.0], [2.3, 2.7], [2.0, 1.6], [1.0, 1.1], [1.5, 1.6], [1.1, 0.9],])mean = X.mean(axis=0, keepdims=True)Xc = X - meanU, s, Vt = np.linalg.svd(Xc, full_matrices=False)components = Vtexplained_variance = s**2 / (X.shape[0] - 1) plt.figure(figsize=(6, 6))plt.scatter(Xc[:, 0], Xc[:, 1], alpha=0.5) for i in range(2): direction = components[i] length = 2.5 * np.sqrt(explained_variance[i]) plt.arrow(0, 0, length * direction[0], length * direction[1], width=0.02, length_includes_head=True) plt.axhline(0)plt.axvline(0)plt.gca().set_aspect("equal", adjustable="box")plt.title("PCA directions from the SVD")plt.show()إذا أردنا reduction إلى أبعاد، نحتفظ بأول أعمدة من . و ratio للمكوّن يصبح
لاحظ المربع. PCA تحاسب variance، ولذلك تدخل ، لا وحدها.
يمكن تلخيص العلاقة في جملة واحدة:
SVD هي آلة المصفوفات؛ PCA أحد أجمل الاستخدامات الإحصائية لهذه الآلة.
SVD في الصور: حين ترى الـ بعينيك
حتى الآن تحدثنا عن approximation وكأننا نحرك رموزًا على الورق. الصورة تجعلنا نرى الخسارة بأعيننا.
الشكل 10: إعادة بناء صورة منخفضة الرتبة باستخدام SVD. تستعيد إعادة البناء بالرتبة k البنية العامة للصورة قبل التفاصيل الدقيقة. تكفي أربع قيم مفردة غير صفرية لإعادة بناء هذا المثال ذي الأبعاد 18 × 18 بدقة، بينما تتطلب الرتب الأقل قيمًا مخزنة أقل.
الصورة الرمادية ذات صفوف و أعمدة يمكن تمثيلها كمصفوفة
حيث تمثل كل قيمة شدة pixel. وبمجرد أن أصبحت الصورة مصفوفة، أصبحت كل قصة SVD صالحة لها:
كل صورة-sized pattern من rank-1. لا يجب أن تتوقع أن تكون الطبقة الأولى “العين” والثانية “الشجرة”. هذه ليست segmentation دلالية؛ إنها أنماط separable رياضية تتراكب لتعيد الصورة.
إذا احتفظنا بأول طبقات فقط نحصل على
عندما يكون صغيرًا تظهر البنية العامة أولًا، ثم تعود التفاصيل مع زيادة . ونسبة الطاقة المحتفظ بها هي
من ناحية التخزين، الصورة الأصلية تحتوي رقمًا، بينما تمثيل rank- يحتاج تقريبًا
رقمًا إذا خزنا و و. هذا يشرح المبدأ الرياضي للضغط، لكنه لا يعني أن JPEG أو WebP يعملان حرفيًا بحفظ هذه العوامل؛ codecs الحقيقية تدخل فيها quantization وentropy coding وتفاصيل هندسية أخرى.
أما صورة RGB فيمكن في أبسط تجربة تعليمية أن نفكك قنوات و و كل واحدة على حدة، ثم نعيد جمعها بعد .
الفائدة من هذا المثال ليست فقط “ضغط صورة”. إنه يمنح Eckart–Young وجهًا نراه: نحذف اتجاهات رياضية، ثم ننظر مباشرة إلى ما اختفى من الصورة.
ضغط الصور بـSVD
from PIL import Imageimport numpy as np img = Image.open("your_image.jpg").convert("L")A = np.asarray(img, dtype=float) U, s, Vt = np.linalg.svd(A, full_matrices=False) k = 40A_k = (U[:, :k] * s[:k]) @ Vt[:k, :]A_k = np.clip(A_k, 0, 255).astype(np.uint8) Image.fromarray(A_k).save("compressed_rank_40.png")جرّب عدة قيم لـ، ثم قارن جودة الصورة بصريًا مع Frobenius error.
SVD داخل الشبكات العصبية
ضغط الشبكات العصبية موضوع أوسع بكثير، لكن هناك جسرًا واحدًا يستحق أن نفتحه لأن الرياضيات هي نفسها تمامًا.
الشكل 11: تفكيك طبقة في شبكة عصبية إلى عوامل منخفضة الرتبة. تُقرب مصفوفة الأوزان الكثيفة W بالتعبير UₖΣₖVₖᵀ، فتُستبدل عملية تحويل خطية كبيرة بعمليتي تحويل أضيق.
طبقة fully connected تبدأ ب:
تجاهل activation لحظة وانظر إلى . إنها مصفوفة. إذن
إذا هبطت singular values بسرعة، يمكننا تقريبها بـ
ضع ذلك داخل الطبقة:
الآن بدل linear layer كبيرة واحدة يمكن أن نفكر في تحويلين خطيين أصغر:
إذا كانت ، فالطبقة الأصلية تحمل weight parameters، بينما العاملان يحتاجان تقريبًا
إذا كان ، فالفرق قد يكون كبيرًا.
لكن هناك تفصيلة لا يجوز القفز فوقها: إذا كان العاملان يستبدلان linear map واحدة، فلا نضع nonlinearity بينهما، وإلا لم نعد نمثل نفس rank- matrix product.
وهنا يظهر اتصال جميل مع PCA. PCA تسأل: هل activations تحتاج فعلًا كل هذه الاتجاهات؟ أما SVD على weights فتسأل: هل weight matrix نفسها تحتاج كل هذه الاتجاهات؟
استكشاف عددي
الصيغتان and ممتازتان للفهم.
لكن في البرمجيات العددية قد يؤدي تكوين صراحةً إلى سوء أكبر في conditioning لأن condition number يُربّع عمليًا. لذلك تستخدم مكتبات SVD الموثوقة خوارزميات أكثر استقرارًا بدل تنفيذ الفكرة النظرية حرفيًا.
إذن افصل بين سؤالين. إذا كان السؤال: من أين جاءت SVD؟ فـ باب جميل للفهم. أما إذا كان السؤال: كيف أحسبها في عمل عددي حقيقي؟ فاستخدم routine موثوقة مثل numpy.linalg.svd أو scipy.linalg.svd أو MATLAB svd. الفهم والتنفيذ مرتبطان، لكنهما ليسا الشيء نفسه.
إشارات صغيرة لا تغيّر القصة
حتى بعد أن نجد SVD، لا يعني ذلك أن كل حرف فيها فريد بالطريقة التي قد نتوقعها. فإذا غيّرنا إشارة و معًا، فإن .
إذن الإشارة يمكن أن تنقلب في الزوج معًا دون أن تتغير المصفوفة.
وإذا تكررت singular value، مثل ، فقد يكون subspace نفسه محددًا بينما لا يكون اختيار basis داخله فريدًا. المهم هنا أن SVD ترتب البنية، لكن بعض التفاصيل التمثيلية يمكن أن تتغير من خوارزمية إلى أخرى دون أن تتغير الحقيقة الرياضية.
أربعة فضاءات في لقطة واحدة
إذا كانت رتبة تساوي ، فإن أول right singular vectors تمتد عليها row space:
أما البقية فتملأ null space:
وعلى جهة الخرج، أول left singular vectors تمتد عليها column space:
والبقية تعطي left null space:
هنا نفهم لماذا يبدو SVD كأنه يجمع فصولًا كثيرة من الجبر الخطي في مشهد واحد: rank وrow space وcolumn space وnull spaces وorthogonality وeigenvectors وapproximation كلها تلتقي في نفس البناء.
ماذا تحمل كل طبقة؟
القطعة يمكن قراءتها بثلاث لهجات مختلفة من نفس اللغة. كـtransformation تقول .
كـrank-1 layer هي لبنة واحدة داخل المصفوفة. وكـdata component، فإن اتجاه على جهة features، بينما يحمل scores على جهة observations، و يتحول — بعد scaling الخاص بالـcovariance — إلى مقدار variance الذي تشرحه هذه الجهة في PCA.
ليست هذه ثلاث نظريات. إنها ثلاث زوايا لنفس الجبر.
الخريطة كاملة
نحتفظ بأقوى الطبقات ونترك الضعيفة.
الشكل 12: خريطة مفاهيم SVD وتطبيقاته. تربط الخريطة بين تركيب المصفوفات وتفكيكها والرتبة وSVD المبتور وPCA وإعادة بناء الصور والطبقات منخفضة الرتبة في الشبكات العصبية.
يمكن ضغط الرحلة كلها في سلسلة واحدة:
ثم
ثم
ثم نحتفظ بالأقوى:
فتعطينا Eckart–Young أفضل rank- approximation، ثم تظهر نفس right singular directions في PCA عندما يكون لدينا centered data.
إذا اختفت كل التفاصيل غدًا، احتفظ بهذه الفكرة:
SVD تبحث عن اتجاهات دخل متعامدة معيارية تتعامل معها المصفوفة بصورة مستقلة، وتخبرنا بقوة كل اتجاه، ثم ترتبها بحيث تصنع أقوى الاتجاهات أفضل وصف منخفض الرتبة للمصفوفة.
الجيران الذين مررنا بهم
LU يكتب ويحوّل Gaussian elimination إلى عامل سفلي وآخر علوي. QR يكتب ويفصل basis orthonormal عن معاملات مثلثية، ولذلك يظهر طبيعيًا في least squares. Cholesky يكتب عندما تكون المصفوفة symmetric positive definite، مستغلًا التماثل بدل حساب عاملين مستقلين.
Spectral decomposition يجعل المصفوفة symmetric في صورة ، حيث الأعمدة في eigenvectors orthonormal و diagonal. Jordan يذهب أبعد نظريًا ليصل إلى صورة قطرية أو شبه قطرية عندما تسمح البنية، لكنه أكثر حساسية عدديًا. Schur يرضى ب لكنه يكسب تحويلًا unitary مستقرًا، ولهذا هو أكثر راحة للحساب العددي.
Polar decomposition يكتب ، فيفصل rotation/reflection عن pure stretching. وإذا كانت لدينا SVD
فيمكن رؤية
أما Interpolative decomposition فيكتب تقريبًا مع اختيار أعمدة فعلية من ، فيكسب interpretability على حساب أن اتجاهاته ليست بالضرورة الاتجاهات المثلى التي تنتجها SVD.
الفكرة التي تجمع الجميع لا تزال كما هي:
من القمة
النظر من القمة نحو الأفق شيء جميل. من هناك يبدو SVD كأن كل شيء اجتمع في لقطة واحدة: اتجاهات نظيفة، وتمدد، وطبقات rank-1، وتقريب منخفض الرتبة، ثم PCA والصور وحتى لمحة من الشبكات العصبية.
لكن القمة تخفي الطريق الذي صنعها. بدأنا بقطع نعرفها فجمعناها، ثم قلبنا السؤال وبدأنا التفكيك. ومع كل طبقة انكشف جزء آخر من الجبل.
النظر من القمة نحو الأفق شيء جميل، لكن ما كنا نحتاجه فقط قفزة إيمان لنرى ممَّا تكوَّن هذا الجبل.
المراجع
Andrews, H. C., & Patterson, C. L. (1976). Singular value decomposition (SVD) image coding. IEEE Transactions on Communications, 24(4), 425–432. https://doi.org/10.1109/TCOM.1976.1093309
Brain Station Advanced. (n.d.). No one taught SVD (singular value decomposition) like this [Video]. YouTube. https://youtu.be/llisH02KLrE
Denton, E. L., Zaremba, W., Bruna, J., LeCun, Y., & Fergus, R. (2014). Exploiting linear structure within convolutional networks for efficient evaluation. In Advances in neural information processing systems (Vol. 27, pp. 1269–1277). https://proceedings.neurips.cc/paper/2014/hash/1adaeb993eba95859121a43ea61bd858-Abstract.html
Existence of the singular value decomposition (SVD): A very detailed step-by-step explanation. (n.d.). [Unpublished study notes].
Jaderberg, M., Vedaldi, A., & Zisserman, A. (2014). Speeding up convolutional neural networks with low rank expansions. In Proceedings of the British Machine Vision Conference 2014. https://doi.org/10.5244/C.28.88
Matrix decompositions: Cohesive summary. (n.d.). [Unpublished study notes].
MIT OpenCourseWare. (n.d.-a). Singular value decomposition [Video]. YouTube. https://youtu.be/TX_vooSnhm8
MIT OpenCourseWare. (n.d.-b). Singular value decomposition (the SVD) [Video]. YouTube. https://youtu.be/mBcLRGuAFUk
Sainath, T. N., Kingsbury, B., Sindhwani, V., Arisoy, E., & Ramabhadran, B. (2013). Low-rank matrix factorization for deep neural network training with high-dimensional output targets. In 2013 IEEE International Conference on Acoustics, Speech and Signal Processing (pp. 6655–6659). https://doi.org/10.1109/ICASSP.2013.6638949
SVD, matrix rank, low-rank approximation, PCA, and the existence proof: A detailed, intuitive, step-by-step study guide. (n.d.). [Unpublished study notes].
Visual . (n.d.). SVD visualized, singular value decomposition explained | SEE Matrix, chapter 3 [Video]. YouTube. https://youtu.be/vSczTbgc8Rc